AI 数字人口播视频怎么做:用一张照片和一段稿子生成会讲话的数字人
AI 数字人口播视频用一张人物照片加一段配音,生成这个人对着镜头讲话的视频。在 RooYun 里用数字人口播(InfiniteTalk)做,每秒 0.09 元,可用赠送积分;只要嘴动、画面已定好时,用更便宜的口播对口型。发布前要确认形象已获授权。
发布于 2026-11-01
文中价格为发稿时的定价,平台价格可能调整,以价格页为准。
AI 数字人口播视频,就是用一张人物照片加一段配音,生成这个人对着镜头讲话的视频,常用来做讲解、企业介绍、知识口播和带货。在 RooYun(如云)里用「数字人口播(InfiniteTalk)」做,每秒 0.09 元,可用赠送积分(取自 2026-10-31 的价目表,以生成前显示为准)。这篇讲完整步骤、用什么模型、各自多少钱,以及发布前要注意什么。
数字人口播视频是什么
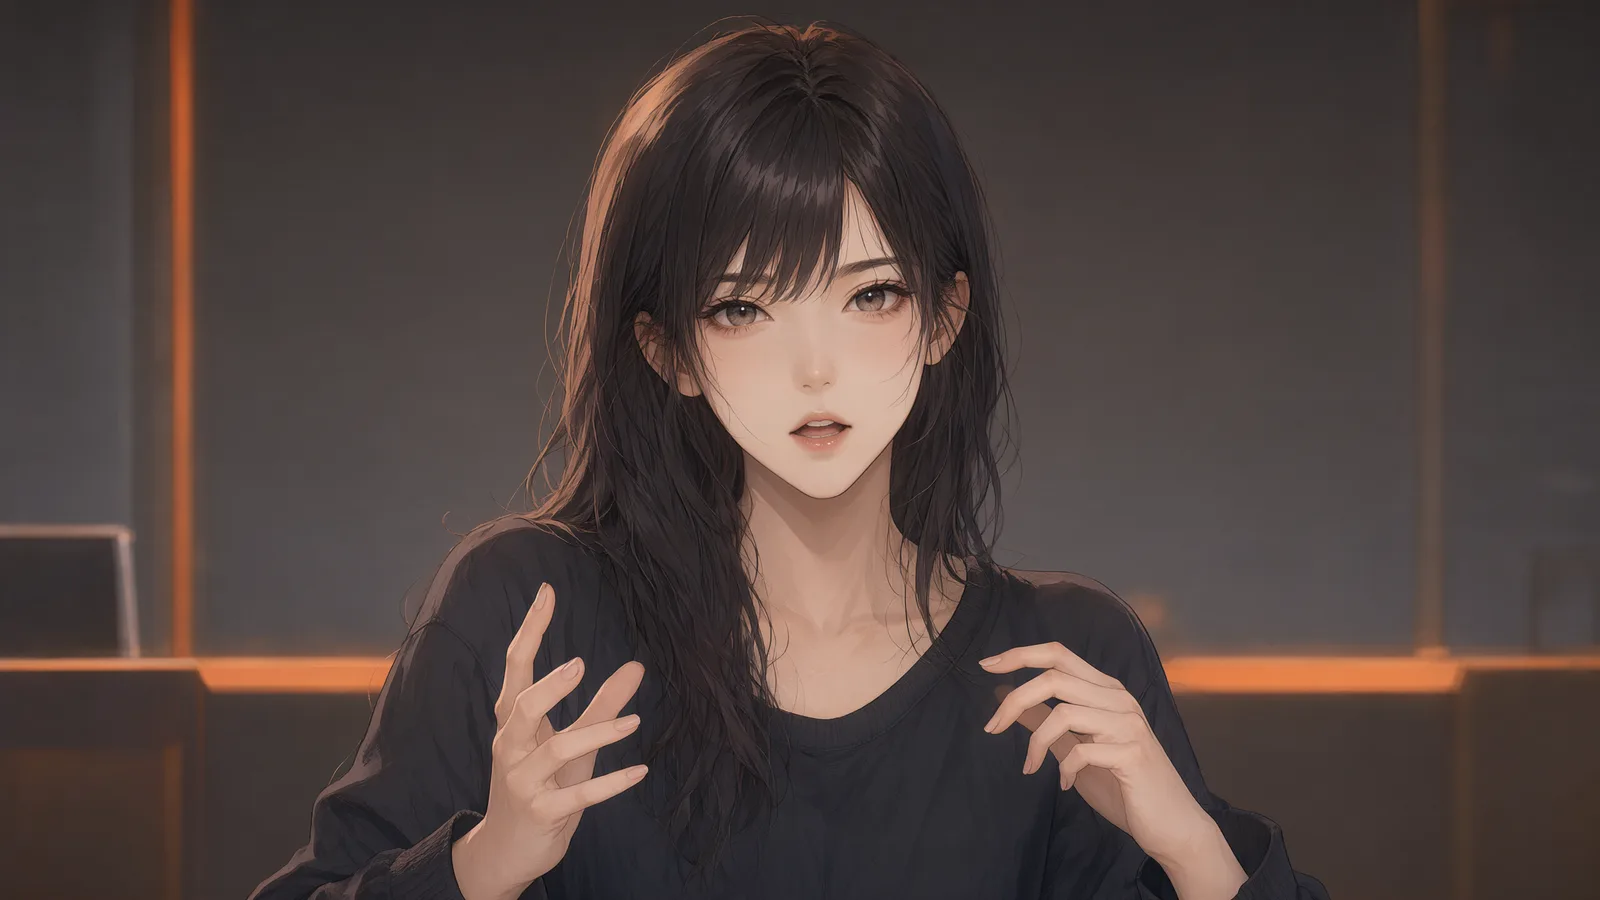
数字人口播是「一张形象照 + 一段配音 → 会讲话的视频」。模型根据音频驱动人物的嘴型、表情和头部动作,让照片里的人像真人一样把这段话讲出来。它不需要真人出镜、不用摄影棚,改稿只要重做配音再生成一遍。
和真人拍摄比,数字人口播省了出镜和拍摄;和纯剪辑比,它能把一段纯文字稿变成有人讲解的视频。
做一条数字人口播要哪几步
- 准备形象照:一张正脸、光线均匀、嘴部和下巴不被头发或手遮挡的人物照片;半身比大头照更自然;
- 写口播稿:按「一句话说清是什么 → 讲两三个要点 → 收尾」写,口语化、短句,30 秒大约 90 到 120 字;
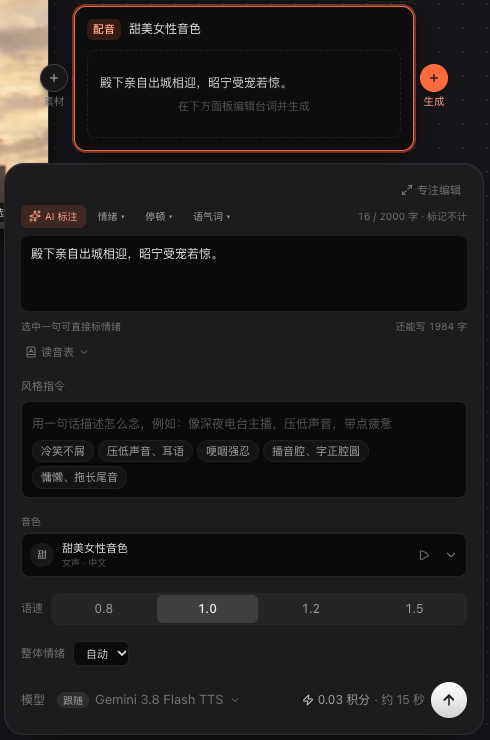
- 生成配音:把口播稿写进配音卡,选音色、语速和情绪生成配音,做法见AI 配音怎么做;
- 生成口播视频:把形象照和配音交给数字人口播,生成这个人讲话的视频;
- 穿插空镜、导出:单独生成几个相关画面(B-roll)剪在讲话中间,避免整条都是一张脸,再导出。
用什么模型、多少钱
下表价格取自 2026-10-31 的价目表,以生成前显示为准。
| 模型 | 价格 | 适合 |
|---|---|---|
| 数字人口播(InfiniteTalk) | 每秒 0.09 元 | 一整段对镜头讲话,带头部和身体动作 |
| 口播对口型(快速,LatentSync) | 每秒 0.072 元 | 画面已定好、只要嘴型跟着音频动 |
两者都可用赠送积分,适合先小成本试一版。配音另算,价格见价格页。以 30 秒口播为例,口播视频约 30 × 0.09 = 2.7 元,再加配音和几个空镜。
数字人口播和口播对口型怎么选
两者都能让人物说话,区别在动作:
- 数字人口播(InfiniteTalk):由音频驱动,除了嘴型还有自然的头部转动和身体小动作,更像真人在讲话,适合从一张照片做出一整段讲解;
- 口播对口型(快速,LatentSync):只把嘴型对到音频上,画面其余部分基本不动,更便宜,适合画面已经拍好或生成好、只差嘴动的情况。
先要一整段会讲话的视频,用数字人口播;已经有满意的画面、只想让嘴动起来,用口播对口型。
形象照怎么选效果才好
- 正脸或微侧,视线对着镜头;
- 光线均匀,脸上没有大片阴影;
- 嘴和下巴露出来,不被头发、口罩、手或麦克风遮住;
- 分辨率够高、人脸清晰;
- 半身构图比只有头部更自然,也方便加手势。
发布前要注意什么
- 肖像授权:数字人形象必须是本人或已获授权,不要用他人或明星的脸;
- 内容属实:口播和字幕里的说法、数字要真实,不用「最」「第一」这类绝对化用语,符合广告法;
- AI 标识:平台会给成品加 AI 生成标识,发布到各平台时按平台规则保留或补充声明。带货场景的完整核对清单见电商带货视频怎么做。
下一步
- AI 配音怎么做:选音色、调语速,把口播配音做干净
- 电商带货视频怎么做:数字人带货口播的完整流程和发布核对
- 5 分钟做出第一段视频:第一次用 RooYun 先跑通一条
- 价格页:数字人口播、配音各档的最新价格
常见问题
做一条数字人口播视频多少钱? 数字人口播每秒 0.09 元、口播对口型每秒 0.072 元,都可用赠送积分;配音另算,价格见价格页。以 30 秒为例,口播视频约 2.7 元,再加配音和几个空镜。具体以生成前显示为准。
只有一张照片能做数字人口播吗? 可以。数字人口播用一张正脸、嘴部露出的人物照片加一段配音,就能生成这个人对着镜头讲话的视频。
数字人口播和口播对口型有什么区别? 数字人口播(InfiniteTalk)由音频驱动,会带上头部和身体动作,更像真人讲话;口播对口型(LatentSync)只对嘴型、更便宜,适合画面已经定好、只要嘴动的情况。
数字人口播视频能商用吗? 需要形象是本人或已获授权,口播内容和数字属实、不用绝对化用语;平台会给成品加 AI 生成标识。